Contenido de este artículo
Ninguna aplicación nace con balanceadores, colas y caché: nace en un único servidor, y así debería ser. La infraestructura madura poco a poco, y cada pieza nueva resuelve un síntoma concreto (lentitud, caídas, un pico de tráfico, una factura que no cuadra), no una moda. Este artículo recorre esa evolución en 10 pasos, con un dibujo del esquema completo después de cada apartado, para ver claramente cómo va quedando la arquitectura en cada uno.
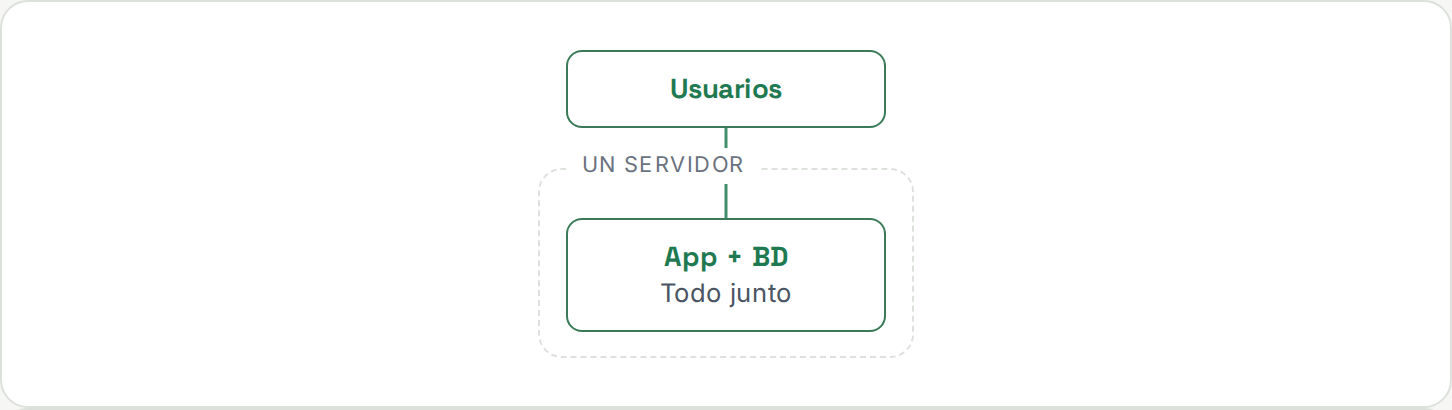
1. Todo en un servidor
Toda infraestructura empieza igual: un servidor, la aplicación y la base de datos conviviendo en la misma máquina. Es la opción más barata y la más simple de entender, y es la correcta mientras el tráfico es bajo y el proyecto está validando si tiene sentido. El error habitual no es empezar así: es quedarse ahí por miedo a tocarlo cuando ya no basta.
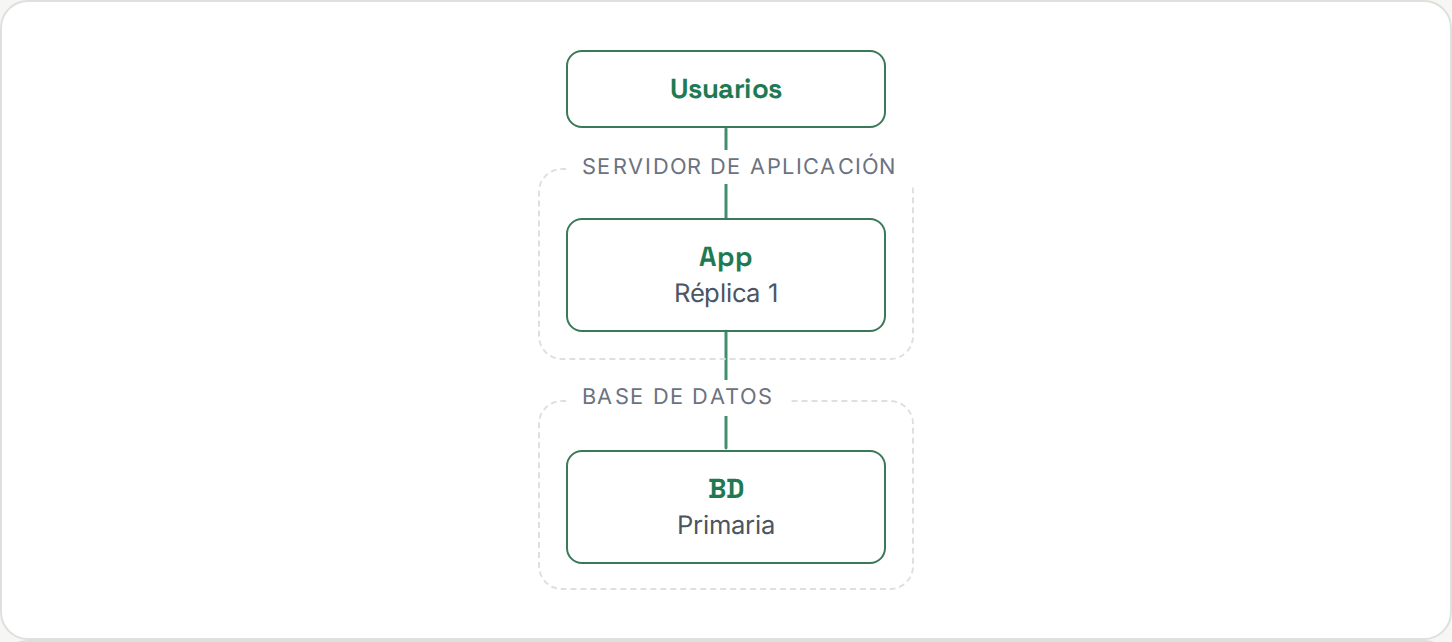
2. Separar la base de datos
El primer síntoma suele ser este: la base de datos y la aplicación compiten por la misma CPU y la misma memoria, y un pico de una afecta a la otra. La solución es mover la base de datos a su propio servidor (en AWS, normalmente una instancia RDS gestionada). A partir de aquí cada pieza escala, se actualiza y falla de forma independiente, y puedes dar copias de seguridad y parches a la base de datos sin tocar la aplicación.
3-4. Escalado vertical y horizontal
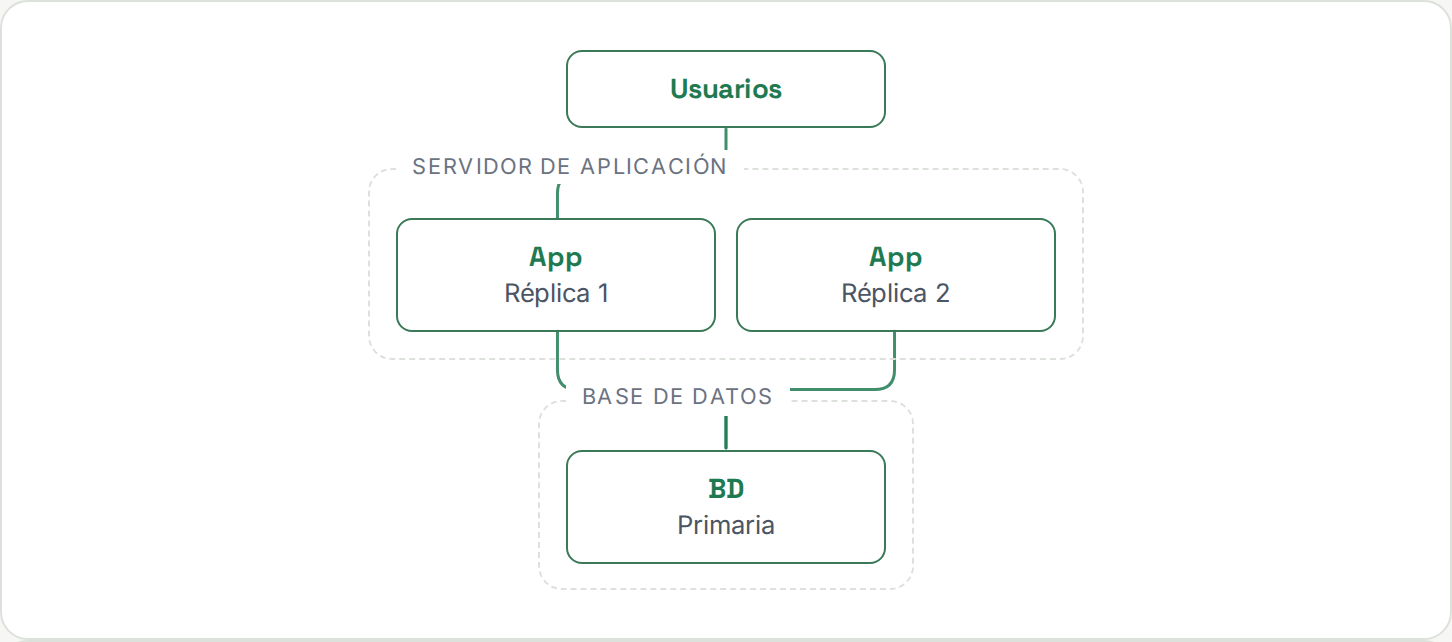
Cuando un servidor empieza a ir justo, hay dos formas de darle más capacidad. La primera y más simple es el escalado vertical: subir de tipo de instancia, con más CPU y RAM en la misma máquina. No añade nada al diagrama de arquitectura, solo cambia el tamaño de una caja que ya existía, y tiene un límite: llega un punto en el que no hay una instancia más grande, o deja de compensar el coste.
El escalado horizontal es distinto: en vez de una máquina más grande, se añaden más máquinas iguales ejecutando la misma aplicación. Cuesta un poco más de disciplina (la aplicación no puede guardar estado solo en memoria local, por ejemplo), pero no tiene techo y de paso gana tolerancia a fallos: si una réplica cae, las demás siguen respondiendo.
Con dos réplicas y sin nada más, alguien tiene que decidir a cuál de las dos llega cada petición. Ahí es donde entra el siguiente paso.
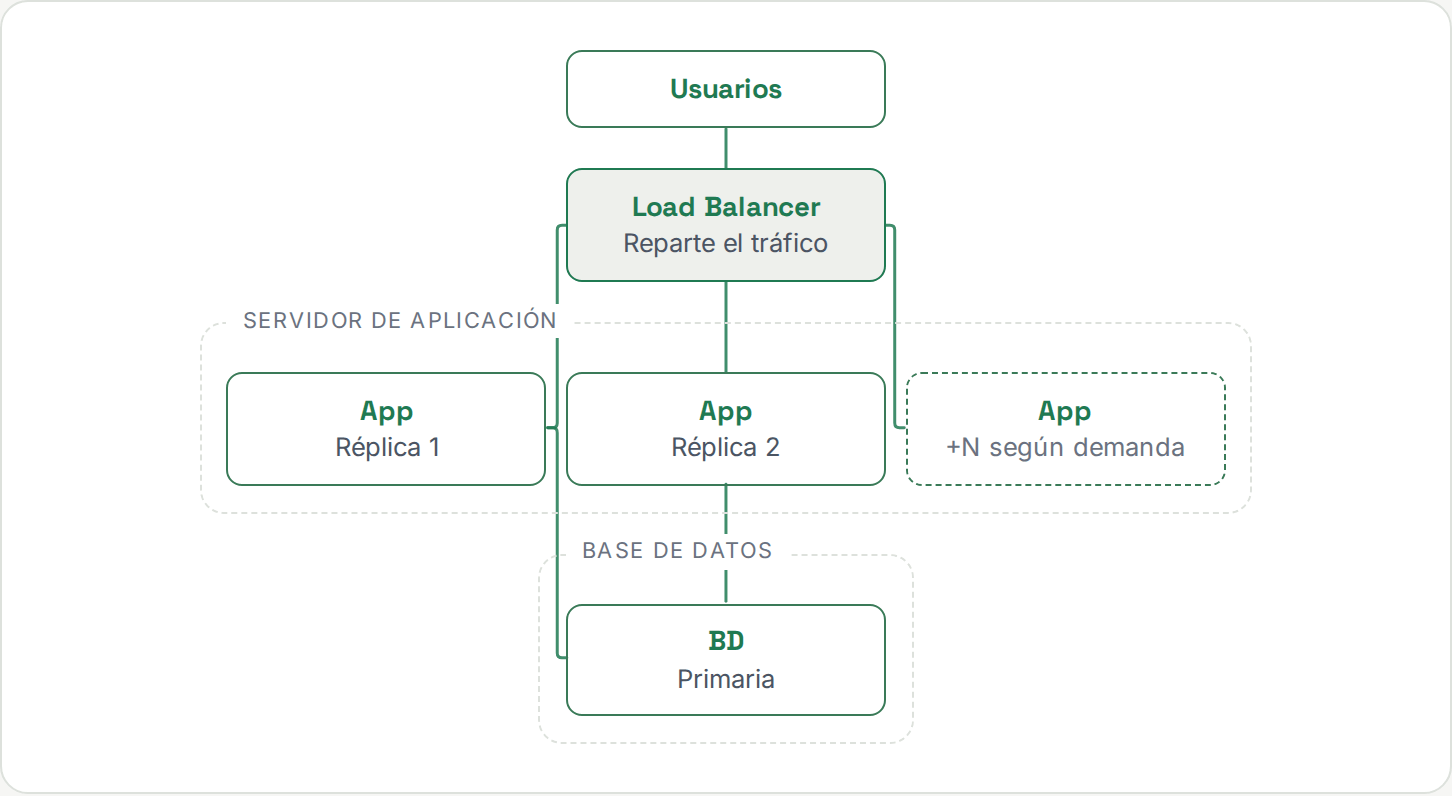
5-6. Load balancer y autoescalado
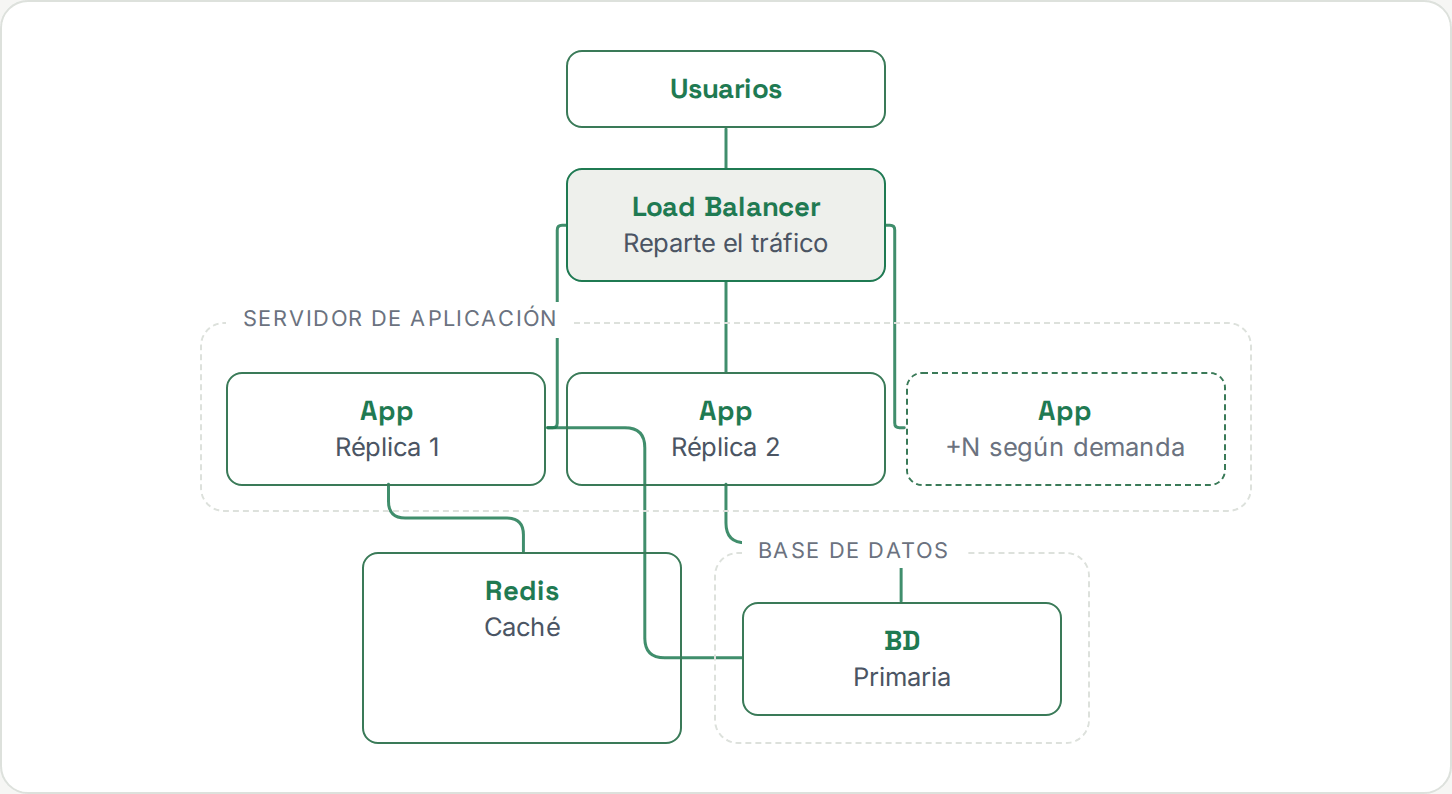
El load balancer (en AWS, un Application Load Balancer) recibe todo el tráfico y lo reparte entre las réplicas sanas de la aplicación. A partir de aquí los usuarios ya no hablan con un servidor concreto, hablan con el balanceador, y eso también permite sacar una réplica de la circulación para actualizarla sin que nadie note un corte.
El autoescalado añade la pieza que faltaba: en vez de decidir a mano cuántas réplicas hay detrás del balanceador, un grupo de autoescalado las añade o las quita según métricas reales (CPU, número de peticiones, hora del día). Se paga por lo que se usa, y el sistema aguanta un pico sin que nadie tenga que levantarse a las 3 de la madrugada a lanzar un servidor más.
7. Caché con Redis
Con más tráfico, muchas consultas a la base de datos son siempre las mismas (un listado de productos, la configuración de la cuenta, un contador de visitas). Guardarlas en una caché en memoria como Redis evita repetir esa consulta cada vez: la aplicación pregunta primero a la caché, y solo si no está ahí va a la base de datos. Es una de las mejoras de rendimiento más baratas de implementar y de las que más se nota, sobre todo bajo carga.
8. Cola de mensajes
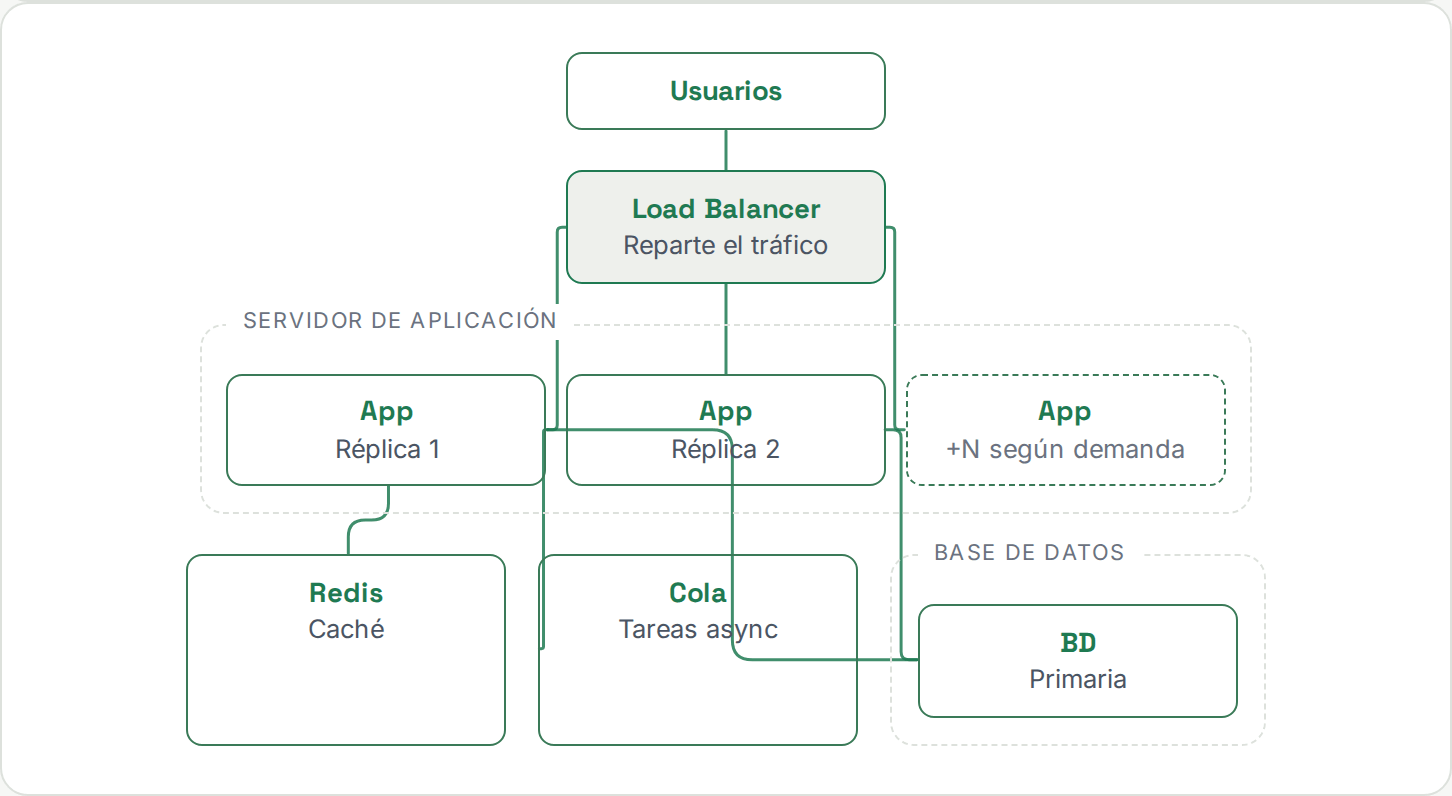
No todo lo que hace una aplicación tiene que pasar mientras el usuario espera la respuesta. Enviar un correo de confirmación, generar un PDF, llamar a una API externa lenta: son tareas que se pueden encolar y procesar aparte, con una cola de mensajes (en AWS, SQS) y un proceso (worker) que la va vaciando. El usuario recibe respuesta al instante, y si la tarea falla se puede reintentar sin que nadie se entere.
9. CDN y réplica de lectura
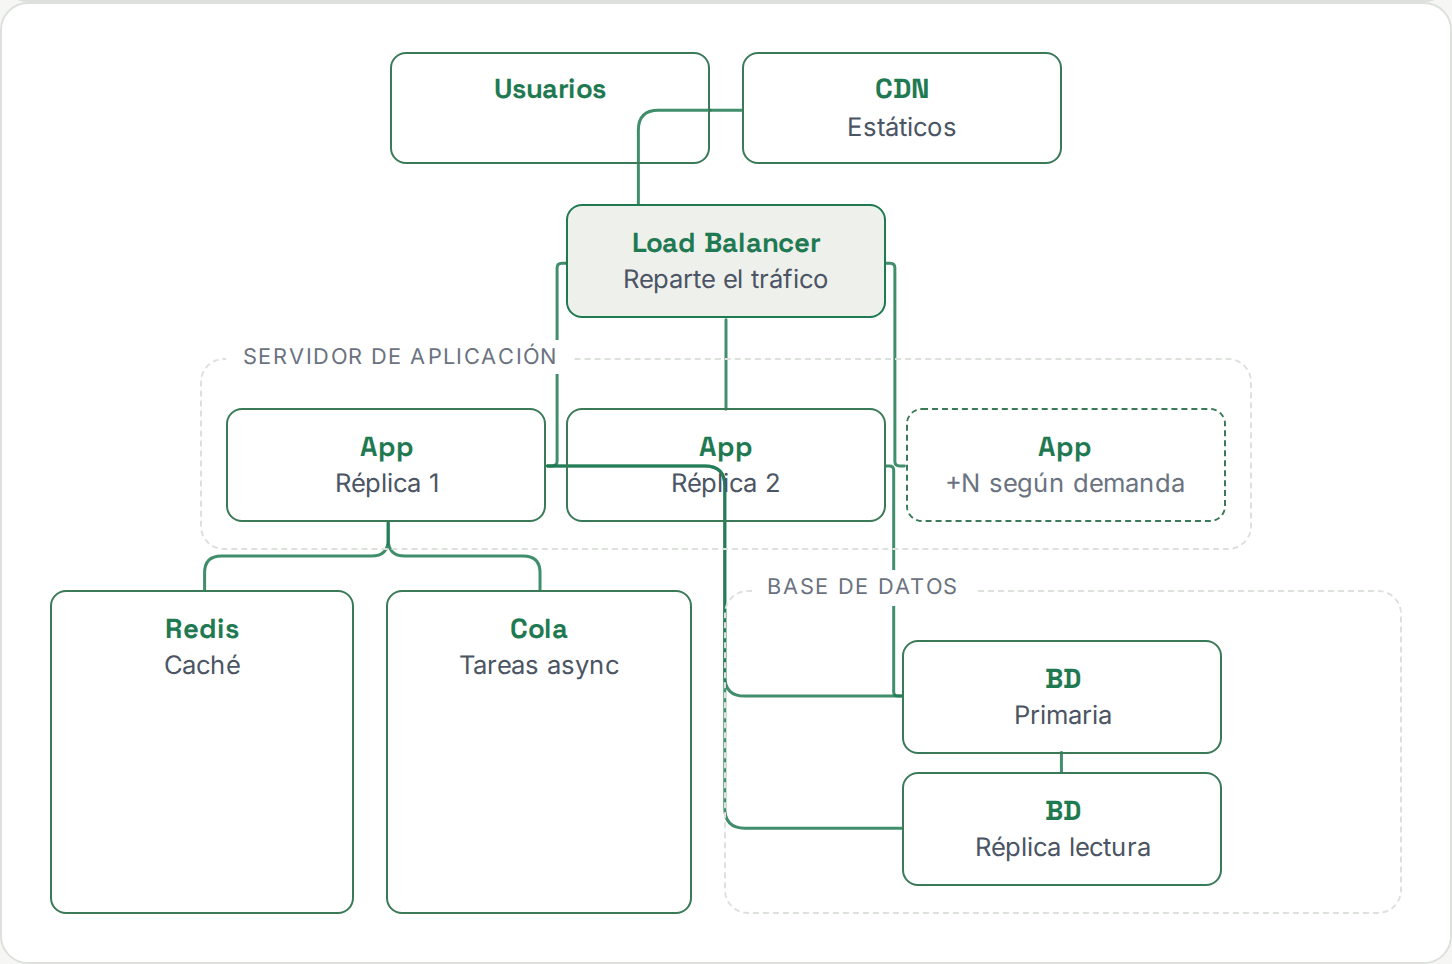
Dos mejoras que suelen llegar juntas cuando el tráfico ya es serio. Una CDN (CloudFront) sirve imágenes, CSS y JS desde un punto cercano al usuario, en vez de desde tu servidor cada vez, lo que además le quita carga al load balancer y a la aplicación. Y una réplica de lectura de la base de datos absorbe las consultas de solo lectura (listados, búsquedas, informes), dejando a la instancia primaria libre para las escrituras, que son las que de verdad no se pueden repartir.
10. Observabilidad y resiliencia
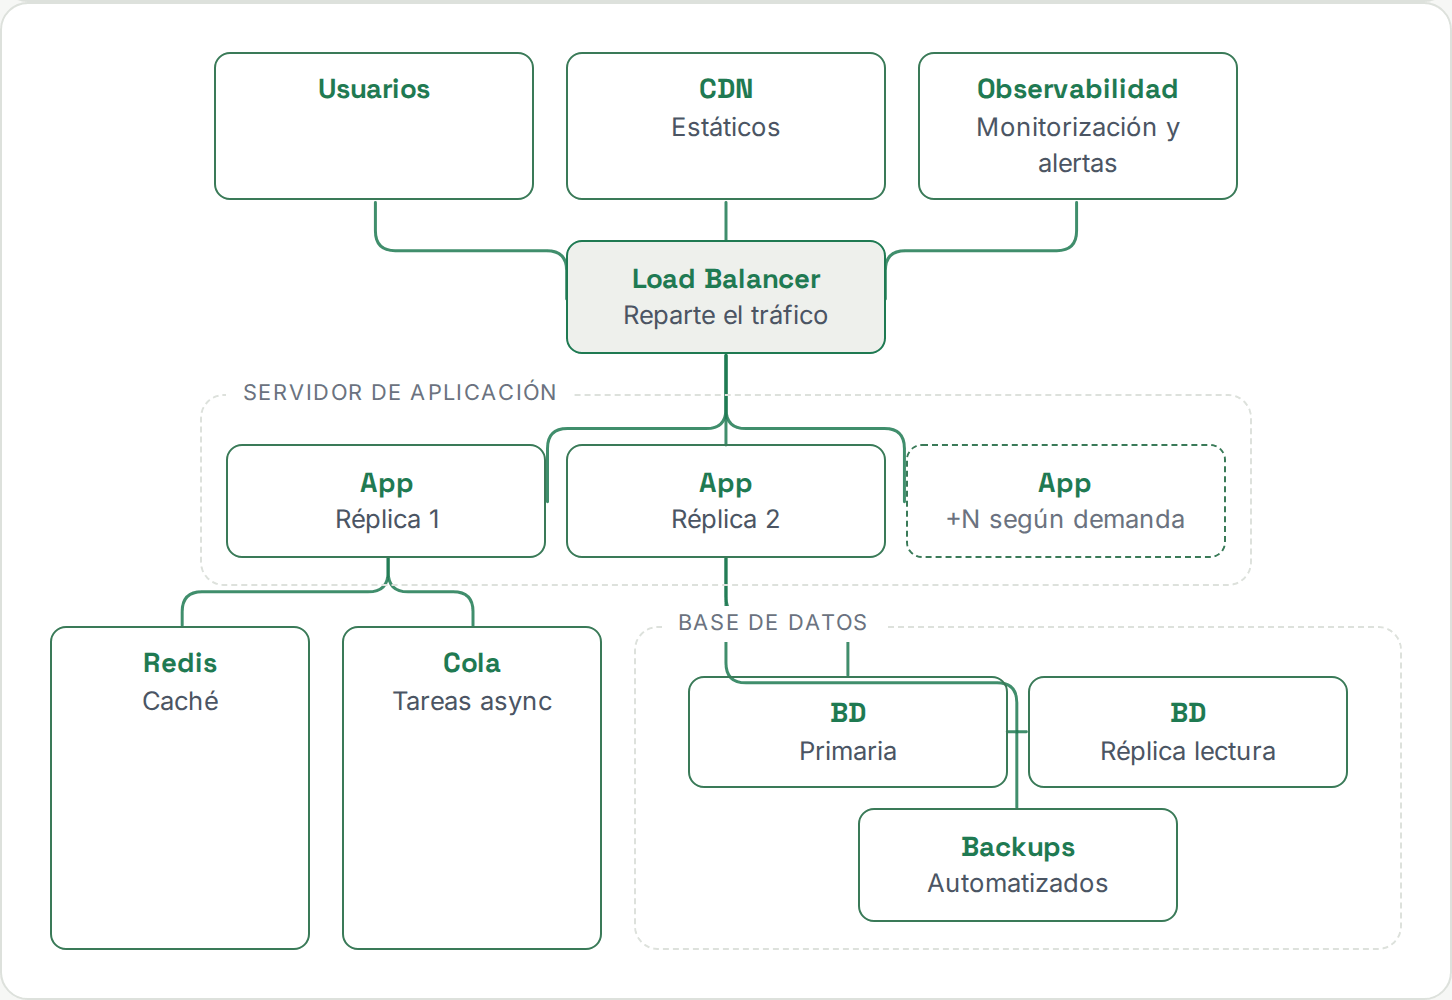
Un sistema con todas las piezas anteriores puede seguir fallando en silencio si nadie lo vigila. La observabilidad (métricas, registros y alarmas, en AWS con CloudWatch) avisa antes de que un problema llegue al usuario: CPU al límite, cola creciendo, tasa de errores subiendo. Y las copias de seguridad automatizadas, probadas de verdad restaurándolas alguna vez, son lo que convierte un fallo grave en un incidente controlado en vez de una pérdida de datos. Con esto, el sistema ya se puede llamar maduro: cada pieza tiene un motivo, y hay alguien (o algo) vigilando cada una.
Qué paso dar primero
No hay una respuesta única, pero sí un criterio: da el paso que resuelve el síntoma que ya tienes, no el que crees que vas a tener. Antes de añadir una pieza, hazte estas preguntas:
- ¿Qué se rompe hoy? Lentitud bajo carga, caídas puntuales, una factura que crece sin control, un despliegue que corta el servicio: cada síntoma apunta a un paso distinto.
- ¿Lo puedo medir? Sin métricas (CPU, tiempo de respuesta, errores) cualquier decisión es una corazonada. La observabilidad del paso 10 no tiene por qué ser lo último que se hace: a veces conviene adelantarla para tomar mejor el resto de decisiones.
- ¿Qué pasa si no lo hago? Muchos proyectos nunca necesitan pasar del paso 2 o 3. Añadir un balanceador o una cola de mensajes sin necesidad solo añade piezas que mantener y que pueden fallar.
- ¿Puedo revertirlo? Los pasos de esta lista son, en general, reversibles y acumulativos: se puede dar uno, medir, y decidir si hace falta el siguiente.
Esta es la parte que menos se ve en un diagrama de arquitectura y la que más dinero ahorra: decidir bien cuándo dar cada paso, no solo saber cómo darlo.
Preguntas habituales
- ¿Hay que dar los 10 pasos siempre, en el mismo orden? No. Cada paso resuelve un síntoma concreto y muchas aplicaciones no necesitan pasar del paso 5 o 6 en toda su vida.
- ¿Cuándo hace falta un load balancer? En cuanto tienes, o vas a tener, más de una réplica de la aplicación, o cuando quieres desplegar sin cortar el servicio.
- ¿Para qué sirve una réplica de lectura de la base de datos? Para repartir las consultas de solo lectura y no saturar la instancia primaria, que sigue siendo la única que acepta escrituras.
- ¿Hace falta una cola de mensajes en una web pequeña? Casi nunca al principio. Empieza a merecer la pena en cuanto aparecen tareas lentas que no deberían bloquear la respuesta al usuario.
- ¿Puedes ayudarme a diseñar o migrar esta arquitectura para mi proyecto? Sí. Diseño y superviso esta evolución en AWS, y ayudo a decidir cuándo merece la pena dar cada paso y cuándo no, como Tech Lead externo.
¿Quieres verlo aplicado a tu caso?Cuéntame tu proyecto; respuesta en menos de 24 horas.
Cuéntame tu caso¿Lo aplicamos en tu caso?Consulta el servicio de despliegue e infraestructura en AWS o el de consultoría y Tech Lead para decidir cuándo dar cada paso, y escríbeme si quieres hablar de tu proyecto.
